

Wie Du Jede Webseite als Sauberes Markdown für LLMs Bekommst
Wenn du einem Sprachmodell eine Webseite gibst, gibst du ihm meistens HTML. Das meiste davon liest niemand: Skripte, Inline-Styles, Tracking-Tags, Cookie-Banner, Navigationsmenüs und Footer-Links. Das Modell muss alles lesen, du bezahlst alles in Tokens, und der Artikel, den du eigentlich wolltest, steckt irgendwo in der Mitte.
Markdown behält, was ein Leser sieht, und lässt den Rest weg. Überschriften bleiben Überschriften, Tabellen bleiben Tabellen, Links bleiben Links. ScrapeUnblocker liefert jetzt jede Seite in dieser Form: Hänge markdown=true an eine Anfrage, und die gerenderte Seite kommt als sauberes Markdown statt als HTML zurück. Diese Anleitung zeigt, warum das hilft, wie du es aus cURL, Python und Node.js aufrufst und wann HTML oder geparstes JSON trotzdem die bessere Wahl ist.
Warum LLMs mit Markdown Besser Arbeiten als mit HTML
Du Bezahlst Jeden Token Ballast
LLM-APIs rechnen pro Token ab, und jedes Modell hat ein Kontextlimit. HTML verbraucht beides größtenteils für Markup. So viel kleiner werden echte Seiten als Markdown:
| Seite | HTML | Markdown |
|---|---|---|
| Wikipedia-Artikel | 230 KB | etwa 51 KB |
| GitHub-Repository-Seite | 317 KB | 10 KB |
| Amazon-Suchergebnisseite | 1,5 MB | 230 KB |
Das Markdown hat etwa 3% bis 22% der ursprünglichen Größe. Bytes sind keine Tokens, aber bei gleichem Text bedeutet eine kleinere Eingabe weniger Tokens. Dasselbe Budget reicht für ein Vielfaches an Seiten, und eine Seite, die als HTML zu groß für das Kontextfenster ist, passt als Markdown womöglich hinein.
Weniger Rauschen im Prompt
Besteht der Prompt hauptsächlich aus Seitengerüst, kann das Modell den falschen Text aufgreifen: ein Widget mit ähnlichen Artikeln, einen Menüpunkt, den Cookie-Hinweis. Beim Retrieval ist es genauso. Teilst du den Rohtext einer Seite in Chunks für einen RAG-Index, bestehen viele Chunks aus Navigations- und Footer-Links, die dann in den Suchergebnissen mit dem echten Inhalt konkurrieren. Markdown des Hauptinhalts gibt dem Modell, und dem Retriever, den Teil der Seite, auf den es ankommt.
Die Struktur Bleibt Erhalten
Die andere übliche Abkürzung ist reiner Text, und dabei geht die Struktur verloren. Eine Tabelle wird zu einer Aneinanderreihung von Wörtern, und eine Überschrift lässt sich nicht mehr von einem Absatz unterscheiden. Markdown bewahrt diese Struktur in einer Form, die Modelle gut lesen: Überschriften markieren Abschnitte, Tabellen behalten ihre Zeilen und Spalten, und Links behalten ihr Ziel, sodass ein Agent ihnen folgen kann.
Was Du Zurückbekommst
Der Response-Body ist Markdown, mit Content-Type: text/markdown. Erhalten bleiben:
- Überschriften, Absätze und Listen
- Tabellen, als Markdown-Tabellen
- Links, mit absoluten URLs
- Bilder, als
 - Codeblöcke
Entfernt werden Skripte, Styles, Cookie-Dialoge, Buttons und Formulare sowie versteckte Elemente. Standardmäßig fallen auch Navigation und Footer weg, mehr dazu weiter unten.
So sieht die Antwort für eine Produktseite auf books.toscrape.com aus, einem Demo-Shop zum Üben von Scraping (die Beschreibung ist gekürzt):
- [Home](https://books.toscrape.com/index.html)
- [Books](https://books.toscrape.com/catalogue/category/books_1/index.html)
- [Poetry](https://books.toscrape.com/catalogue/category/books/poetry_23/index.html)
- A Light in the Attic
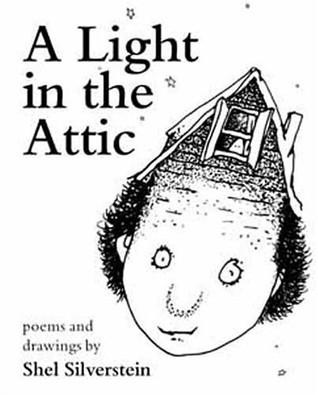
# A Light in the Attic
£51.77
In stock (22 available)
## Product Description
It's hard to imagine a world without A Light in the Attic. ...
## Product Information
| UPC | a897fe39b1053632 |
| --- | --- |
| Product Type | Books |
| Price (excl. tax) | £51.77 |
| Price (incl. tax) | £51.77 |
| Tax | £0.00 |
| Availability | In stock (22 available) |
| Number of reviews | 0 |Breadcrumb, Titelbild mit Alt-Text, Preis und die Tabelle mit den Produktdetails kommen vollständig an, und die Links zeigen auf vollständige URLs.
Wie Du Markdown Anforderst
cURL
Hänge markdown=true an eine normale /getPageSource-Anfrage:
curl -X POST "https://api.scrapeunblocker.com/getPageSource?url=https://en.wikipedia.org/wiki/Web_scraping&markdown=true" \
  -H "x-scrapeunblocker-key: YOUR_API_KEY"
Python
Mit einfachem requests:
import requests

r = requests.post(
    "https://api.scrapeunblocker.com/getPageSource",
    params={"url": "https://en.wikipedia.org/wiki/Web_scraping", "markdown": True},
    headers={"x-scrapeunblocker-key": "YOUR_API_KEY"},
    timeout=120,
)
r.raise_for_status()
markdown = r.text
Oder mit dem offiziellen SDK (pip install scrapeunblocker, Version 0.13.0 oder neuer), das deinen Schlüssel aus der Umgebungsvariable SCRAPEUNBLOCKER_KEY liest:
from scrapeunblocker import Client

su = Client()  # liest SCRAPEUNBLOCKER_KEY
markdown = su.get_markdown("https://en.wikipedia.org/wiki/Web_scraping")
Node.js
import { ScrapeUnblockerClient } from "scrapeunblocker";

const su = new ScrapeUnblockerClient(); // liest SCRAPEUNBLOCKER_KEY
const markdown = await su.getMarkdown("https://en.wikipedia.org/wiki/Web_scraping");
Das Ruby-SDK hat denselben Aufruf als get_markdown, das PHP-SDK als getMarkdown.
Nur der Hauptinhalt oder die Ganze Seite
Standardmäßig bekommst du nur den Hauptinhalt der Seite. Navigation, Website-Header, Footer und Seitenleisten bleiben draußen, weil sie sich auf jeder Seite einer Website wiederholen und die Frage, die du stellst, selten beantworten. Diese Voreinstellung ist main_content_only=true.
Manchmal liegt der Teil, den du brauchst, außerhalb des Hauptinhalts: Kontaktdaten im Footer oder die Navigationslinks, wenn ein Agent den Rest der Website erkunden soll. Setze main_content_only=false, um die ganze Seite umzuwandeln:
curl -X POST "https://api.scrapeunblocker.com/getPageSource?url=https://example.com&markdown=true&main_content_only=false" \
  -H "x-scrapeunblocker-key: YOUR_API_KEY"
Im Python-SDK ist das su.get_markdown(url, main_content_only=False).
Es Funktioniert auf Geschützten Seiten
HTML in Markdown umzuwandeln ist der einfache Teil. Viele Open-Source-Bibliotheken können das, und du kannst selbst eine betreiben. Schwierig ist es, überhaupt an die echte Seite zu kommen. Gib einem Konverter eine Cloudflare-Challenge oder eine leere JavaScript-Hülle, und du bekommst eine ordentliche Markdown-Kopie der Challenge-Seite.
Eine Markdown-Anfrage läuft durch dieselbe Pipeline wie eine HTML-Anfrage:
- JavaScript-Rendering in einem echten Browser, damit Seiten, die ihren Inhalt clientseitig aufbauen, vollständig zurückkommen.
- Anti-Bot-Umgehung für Cloudflare, DataDome, PerimeterX und Akamai.
- Länder-Targeting mit
proxy_country, für Seiten, die sich je nach Standort unterscheiden. - Browser-Schritte mit
steps: Klicke auf “Mehr laden”, tippe in ein Suchfeld oder warte auf ein Element, und die Seite wird nach den Schritten umgewandelt. - Live-Seiten. Jeder Aufruf holt die Seite in ihrem aktuellen Zustand; nichts kommt aus einem Cache.
Auch der Preis ändert sich nicht. Ein Markdown-Aufruf wird genau wie ein HTML-Aufruf abgerechnet, und nur, wenn die Seite geliefert wird. Blockierungen, Timeouts und Fehler auf unserer Seite kosten nichts.
Markdown, Geparste Daten oder HTML?
Alle drei kommen vom selben Endpoint, also entscheide danach, was als Nächstes mit der Seite passiert:
| Du willst | Nutze |
|---|---|
| Eine Seite an ein LLM geben: Zusammenfassungen, Fragen und Antworten, RAG, Agenten | markdown=true |
| Felder in einer Datenbank speichern: Preis, Titel, Verfügbarkeit, Spezifikationen | parsed_data=true |
| Eigene Selektoren oder Parser ausführen | das Standard-HTML |
Markdown ist zum Lesen da. Brauchst du einen Preis als Zahl in einer Spalte, liefert parsed_data=true strukturiertes JSON, und unsere Anleitung zu Schema.org- und JSON-LD-Daten erklärt, woher diese Felder meist stammen. Jede dieser Optionen liefert ihr eigenes Format, deshalb lässt sich markdown=true nicht mit parsed_data, get_cookies oder list_elements kombinieren. Eine solche Anfrage wird mit 422 abgelehnt.
Beispiel: Eine Seite für einen RAG-Index in Chunks Teilen
Markdown-Überschriften liefern natürliche Stellen, an denen du eine Seite teilen kannst. Diese Skizze holt einen Artikel und fasst seine Abschnitte zu Chunks von bis zu etwa 4.000 Zeichen zusammen, bereit für dein Embedding-Modell:
import re
from scrapeunblocker import Client

su = Client()

def chunk_markdown(md, max_chars=4000):
    chunks, current = [], ""
    for section in re.split(r"\n(?=#{1,3} )", md):
        if current.strip() and len(current) + len(section) > max_chars:
            chunks.append(current.strip())
            current = ""
        current += section + "\n"
    if current.strip():
        chunks.append(current.strip())
    return chunks

md = su.get_markdown("https://en.wikipedia.org/wiki/Web_scraping")
for chunk in chunk_markdown(md):
    print(len(chunk), chunk.splitlines()[0][:70])
Die Chunks werden nur an Überschriften getrennt, also enthält jeder ganze Abschnitte und beginnt mit seiner eigenen Überschrift als Kontext. Ein Abschnitt, der länger als das Limit ist, bleibt am Stück. Zwei Verbesserungen für den Produktivbetrieb: Teile sehr lange Abschnitte an Absatzgrenzen, und ignoriere #-Zeilen in Codeblöcken, denn das sind Kommentare, keine Überschriften.
Für KI-Assistenten: Der MCP-Server
Läuft dein Agent in Claude, ChatGPT, Cursor oder einem anderen MCP-Client, musst du die Anfrage nicht selbst schreiben. Der MCP-Server von ScrapeUnblocker hat ein Tool fetch_markdown, das eine Seite als Markdown liest, und search_and_read, das eine Google-Suche ausführt und die ersten Treffer in einem Aufruf als Markdown zurückgibt.
FAQ
Kostet Markdown mehr als HTML?
Nein. Ein Markdown-Aufruf wird genau wie ein HTML-Aufruf abgerechnet, und nur, wenn die Seite geliefert wird.
Kann ich auch Navigation und Footer bekommen?
Ja. Füge main_content_only=false hinzu, und die ganze Seite wird umgewandelt. Ohne den Parameter bekommst du nur den Hauptinhalt.
Funktioniert es mit geschützten und JavaScript-lastigen Seiten?
Ja. Die Seite wird in einem echten Browser gerendert und über dieselbe Anti-Bot-Umgehung geholt wie bei einem HTML-Aufruf, und proxy_country und steps funktionieren genauso.
Kann ich markdown=true mit parsed_data=true kombinieren?
Nein. Jede Option liefert ihr eigenes Format, deshalb beantwortet die API diese Kombination mit 422. Wenn du beides brauchst, mach zwei Aufrufe.
Probier Es mit Deinen Eigenen Seiten Aus
Jedes neue Konto bekommt 500 kostenlose Anfragen ohne Karte, und ein Markdown-Aufruf kostet eine Anfrage wie jede andere Seite. Registriere dich auf app.scrapeunblocker.com, hänge markdown=true an deine nächste Anfrage und lies die Markdown-Anleitung in der Dokumentation für alle Optionen.
ScrapeUnblocker kostenlos testen
Über 95 % Erfolgsquote · ab 0,55 € pro 1.000 Aufrufe (ggf. zzgl. MwSt.) · 500 kostenlose Anfragen bei der Registrierung.