

Comment Obtenir N'importe Quelle Page Web en Markdown Propre pour les LLM
Quand vous donnez une page web à un modèle de langage, vous lui donnez en général du HTML. Et l’essentiel de ce HTML n’est pas ce que l’on lit : des scripts, des styles en ligne, des balises de suivi, des bandeaux de cookies, des menus de navigation et des liens de pied de page. Le modèle doit tout lire, vous payez tout en tokens, et l’article que vous vouliez vraiment se trouve quelque part au milieu.
Le Markdown garde ce que voit un lecteur et laisse tomber le reste. Les titres restent des titres, les tableaux restent des tableaux, les liens restent des liens. ScrapeUnblocker peut désormais renvoyer n’importe quelle page sous cette forme : ajoutez markdown=true à une requête et la page rendue revient en Markdown propre au lieu de HTML. Ce guide explique pourquoi c’est utile, comment l’appeler depuis cURL, Python et Node.js, et quand le HTML ou le JSON parsé restent le meilleur choix.
Pourquoi les LLM Travaillent Mieux avec du Markdown qu’avec du HTML
Vous Payez Chaque Token de Remplissage
Les API de LLM facturent au token, et chaque modèle a une limite de contexte. Le HTML en consomme l’essentiel en balisage. Voici à quel point de vraies pages rétrécissent en Markdown :
| Page | HTML | Markdown |
|---|---|---|
| Article Wikipédia | 230 Ko | environ 51 Ko |
| Page d’un dépôt GitHub | 317 Ko | 10 Ko |
| Page de résultats de recherche Amazon | 1,5 Mo | 230 Ko |
Le Markdown représente environ 3 % à 22 % de la taille d’origine. Des octets ne sont pas des tokens, mais pour un même texte, une entrée plus petite signifie moins de tokens. Le même budget couvre plusieurs fois plus de pages, et une page trop grosse pour une fenêtre de contexte en HTML peut y tenir en Markdown.
Moins de Bruit dans le Prompt
Quand le prompt est surtout fait de l’habillage de la page, le modèle peut s’accrocher au mauvais texte : un widget d’articles similaires, un libellé de menu, l’avis sur les cookies. La recherche documentaire en souffre de la même façon. Découpez le texte brut d’une page en fragments pour un index RAG, et beaucoup de fragments ne contiennent que des liens de navigation et de pied de page, qui font ensuite concurrence au vrai contenu dans les résultats. Le Markdown du contenu principal donne au modèle, et au moteur de recherche documentaire, la partie de la page qui compte.
La Structure Est Préservée
L’autre raccourci courant est l’extraction de texte brut, et elle fait perdre la structure. Un tableau devient une suite de mots, et l’on ne distingue plus un titre d’un paragraphe. Le Markdown garde cette structure sous une forme que les modèles lisent bien : les titres délimitent les sections, les tableaux gardent leurs lignes et leurs colonnes, et les liens gardent leur cible, si bien qu’un agent peut les suivre.
Ce Que Vous Recevez
Le corps de la réponse est du Markdown, avec Content-Type: text/markdown. Il conserve :
- les titres, les paragraphes et les listes
- les tableaux, en tableaux Markdown
- les liens, avec des URL absolues
- les images, sous la forme
 - les blocs de code
Il supprime les scripts, les styles, les fenêtres de cookies, les boutons et formulaires, et les éléments masqués. Par défaut, il laisse aussi de côté la navigation et le pied de page, nous y revenons plus bas.
Voici la réponse pour une page produit de books.toscrape.com, une boutique de démonstration conçue pour s’entraîner au scraping (la description est raccourcie) :
- [Home](https://books.toscrape.com/index.html)
- [Books](https://books.toscrape.com/catalogue/category/books_1/index.html)
- [Poetry](https://books.toscrape.com/catalogue/category/books/poetry_23/index.html)
- A Light in the Attic
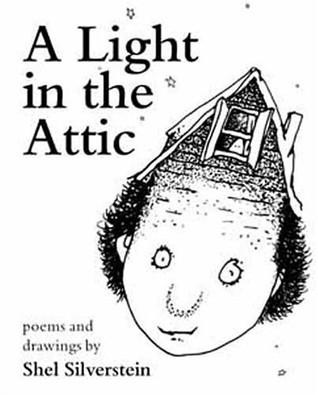
# A Light in the Attic
£51.77
In stock (22 available)
## Product Description
It's hard to imagine a world without A Light in the Attic. ...
## Product Information
| UPC | a897fe39b1053632 |
| --- | --- |
| Product Type | Books |
| Price (excl. tax) | £51.77 |
| Price (incl. tax) | £51.77 |
| Tax | £0.00 |
| Availability | In stock (22 available) |
| Number of reviews | 0 |Le fil d’Ariane, l’image de couverture avec son texte alternatif, le prix et le tableau des détails du produit arrivent intacts, et les liens pointent vers des URL complètes.
Comment Demander du Markdown
cURL
Ajoutez markdown=true à une requête /getPageSource normale :
curl -X POST "https://api.scrapeunblocker.com/getPageSource?url=https://en.wikipedia.org/wiki/Web_scraping&markdown=true" \
  -H "x-scrapeunblocker-key: YOUR_API_KEY"
Python
Avec requests seul :
import requests

r = requests.post(
    "https://api.scrapeunblocker.com/getPageSource",
    params={"url": "https://en.wikipedia.org/wiki/Web_scraping", "markdown": True},
    headers={"x-scrapeunblocker-key": "YOUR_API_KEY"},
    timeout=120,
)
r.raise_for_status()
markdown = r.text
Ou avec le SDK officiel (pip install scrapeunblocker, version 0.13.0 ou ultérieure), qui lit votre clé dans la variable d’environnement SCRAPEUNBLOCKER_KEY :
from scrapeunblocker import Client

su = Client()  # lit SCRAPEUNBLOCKER_KEY
markdown = su.get_markdown("https://en.wikipedia.org/wiki/Web_scraping")
Node.js
import { ScrapeUnblockerClient } from "scrapeunblocker";

const su = new ScrapeUnblockerClient(); // lit SCRAPEUNBLOCKER_KEY
const markdown = await su.getMarkdown("https://en.wikipedia.org/wiki/Web_scraping");
Le SDK Ruby propose le même appel sous le nom get_markdown, et le SDK PHP sous le nom getMarkdown.
Le Contenu Principal Seul, ou la Page Entière
Par défaut, vous recevez uniquement le contenu principal de la page. La navigation, l’en-tête du site, le pied de page et les barres latérales sont laissés de côté, car ils se répètent sur chaque page d’un site et répondent rarement à la question que vous posez. Ce comportement par défaut correspond à main_content_only=true.
Parfois, la partie dont vous avez besoin se trouve hors du contenu principal : les coordonnées dans le pied de page, ou les liens de navigation quand un agent doit explorer le reste du site. Passez main_content_only=false pour convertir la page entière :
curl -X POST "https://api.scrapeunblocker.com/getPageSource?url=https://example.com&markdown=true&main_content_only=false" \
  -H "x-scrapeunblocker-key: YOUR_API_KEY"
Dans le SDK Python, c’est su.get_markdown(url, main_content_only=False).
Cela Fonctionne sur les Sites Protégés
Convertir du HTML en Markdown est la partie facile. De nombreuses bibliothèques open source le font, et vous pouvez en faire tourner une vous-même. Le plus dur est d’obtenir la vraie page. Donnez à un convertisseur un challenge Cloudflare ou une coquille JavaScript vide, et vous obtenez une copie Markdown bien propre de la page de challenge.
Une requête Markdown passe par le même pipeline qu’une requête HTML :
- Rendu JavaScript dans un vrai navigateur, pour que les pages qui construisent leur contenu côté client reviennent complètes.
- Contournement anti-bot pour Cloudflare, DataDome, PerimeterX et Akamai.
- Ciblage par pays avec
proxy_country, pour les pages qui changent selon le lieu. - Étapes de navigateur avec
steps: cliquez sur « Charger plus », tapez dans un champ de recherche ou attendez un élément, et la page est convertie une fois les étapes exécutées. - Pages en direct. Chaque appel récupère la page telle qu’elle est maintenant ; rien ne vient d’un cache.
Le prix ne change pas non plus. Un appel Markdown est facturé exactement comme un appel HTML, et seulement quand la page est livrée. Les blocages, les délais dépassés et les erreurs de notre côté ne coûtent rien.
Markdown, Données Parsées ou HTML ?
Les trois viennent du même endpoint, alors choisissez selon ce que vous ferez ensuite de la page :
| Vous voulez | Utilisez |
|---|---|
| Donner une page à un LLM : résumés, questions-réponses, RAG, agents | markdown=true |
| Stocker des champs dans une base de données : prix, titre, disponibilité, caractéristiques | parsed_data=true |
| Lancer vos propres sélecteurs ou parsers | le HTML par défaut |
Le Markdown sert à lire. Si vous avez besoin d’un prix sous forme de nombre dans une colonne, parsed_data=true renvoie du JSON structuré, et notre guide sur les données Schema.org et JSON-LD explique d’où viennent généralement ces champs. Chacune de ces options renvoie son propre format, donc markdown=true ne peut pas être combiné avec parsed_data, get_cookies ou list_elements. Une telle requête est rejetée avec une erreur 422.
Exemple : Découper une Page pour un Index RAG
Les titres Markdown offrent des points de découpe naturels. Ce croquis récupère un article et regroupe ses sections en fragments d’environ 4 000 caractères au maximum, prêts pour votre modèle d’embeddings :
import re
from scrapeunblocker import Client

su = Client()

def chunk_markdown(md, max_chars=4000):
    chunks, current = [], ""
    for section in re.split(r"\n(?=#{1,3} )", md):
        if current.strip() and len(current) + len(section) > max_chars:
            chunks.append(current.strip())
            current = ""
        current += section + "\n"
    if current.strip():
        chunks.append(current.strip())
    return chunks

md = su.get_markdown("https://en.wikipedia.org/wiki/Web_scraping")
for chunk in chunk_markdown(md):
    print(len(chunk), chunk.splitlines()[0][:70])
Les fragments ne sont coupés qu’aux titres : chacun contient des sections entières et commence par son propre titre, qui lui sert de contexte. Une section plus longue que la limite reste d’un seul tenant. Deux améliorations pour la production : découpez les sections très longues aux sauts de paragraphe, et ignorez les lignes # à l’intérieur des blocs de code, qui sont des commentaires et non des titres.
Pour les Assistants IA : le Serveur MCP
Si votre agent tourne dans Claude, ChatGPT, Cursor ou un autre client MCP, vous n’avez pas à écrire la requête vous-même. Le serveur MCP de ScrapeUnblocker dispose d’un outil fetch_markdown qui lit une page en Markdown, et de search_and_read, qui lance une recherche Google et renvoie les premiers résultats en Markdown en un seul appel.
FAQ
Le Markdown coûte-t-il plus cher que le HTML ?
Non. Un appel Markdown est facturé exactement comme un appel HTML, et seulement quand la page est livrée.
Puis-je aussi obtenir la navigation et le pied de page ?
Oui. Ajoutez main_content_only=false et toute la page est convertie. Sans ce paramètre, vous recevez uniquement le contenu principal.
Cela fonctionne-t-il sur les pages protégées ou très dépendantes du JavaScript ?
Oui. La page est rendue dans un vrai navigateur et récupérée avec le même contournement anti-bot qu’un appel HTML, et proxy_country et steps fonctionnent de la même façon.
Puis-je combiner markdown=true et parsed_data=true ?
Non. Chacun renvoie son propre format, donc l’API répond à cette combinaison par une erreur 422. Si vous avez besoin des deux, faites deux appels.
Essayez sur Vos Propres Pages
Chaque nouveau compte reçoit 500 requêtes gratuites, sans carte bancaire, et un appel Markdown coûte une requête comme n’importe quelle autre page. Inscrivez-vous sur app.scrapeunblocker.com, ajoutez markdown=true à votre prochaine requête et consultez le guide Markdown dans la documentation pour toutes les options.
Essayez ScrapeUnblocker gratuitement
Taux de réussite de plus de 95 % · à partir de 0,55 € pour 1 000 appels (TVA éventuelle en sus) · 500 requêtes gratuites à l'inscription.