

Cómo Obtener Cualquier Página Web como Markdown Limpio para LLMs
Cuando le das una página web a un modelo de lenguaje, normalmente le das HTML. Y la mayor parte de ese HTML no es lo que alguien lee: scripts, estilos en línea, etiquetas de seguimiento, avisos de cookies, menús de navegación y enlaces del pie de página. El modelo tiene que leerlo todo, tú lo pagas todo en tokens, y el artículo que de verdad querías queda perdido en algún punto del medio.
Markdown conserva lo que ve un lector y descarta el resto. Los encabezados siguen siendo encabezados, las tablas siguen siendo tablas y los enlaces siguen siendo enlaces. ScrapeUnblocker ya puede devolver cualquier página en ese formato: añade markdown=true a una petición y la página renderizada vuelve como Markdown limpio en lugar de HTML. Esta guía explica por qué ayuda, cómo usarlo desde cURL, Python y Node.js, y cuándo el HTML o el JSON parseado siguen siendo la mejor opción.
Por Qué los LLMs Funcionan Mejor con Markdown que con HTML
Pagas Cada Token de Relleno
Las APIs de LLM cobran por token y cada modelo tiene un límite de contexto. El HTML gasta la mayor parte de ambos en marcado. Así se reducen páginas reales al pasarlas a Markdown:
| Página | HTML | Markdown |
|---|---|---|
| Artículo de Wikipedia | 230 KB | unos 51 KB |
| Página de un repositorio de GitHub | 317 KB | 10 KB |
| Página de resultados de búsqueda de Amazon | 1,5 MB | 230 KB |
El Markdown ocupa aproximadamente entre un 3% y un 22% del tamaño original. Los bytes no son tokens, pero con el mismo texto, una entrada más pequeña significa menos tokens. El mismo presupuesto alcanza para varias veces más páginas, y una página demasiado grande para la ventana de contexto en HTML puede caber como Markdown.
Menos Ruido en el Prompt
Cuando la mayor parte del prompt es el envoltorio de la página, el modelo puede quedarse con el texto equivocado: un widget de artículos relacionados, una etiqueta del menú, el aviso de cookies. La recuperación sufre igual. Si divides el texto bruto de una página en fragmentos para un índice RAG, muchos fragmentos serán enlaces de navegación y del pie, que luego compiten con el contenido real en los resultados de búsqueda. El Markdown del contenido principal le da al modelo, y al sistema de recuperación, la parte de la página que importa.
La Estructura Se Mantiene
Extraer texto plano es el otro atajo habitual, y con él se pierde la estructura. Una tabla se convierte en una ristra de palabras y ya no distingues un encabezado de un párrafo. Markdown conserva esa estructura en un formato que los modelos leen bien: los encabezados marcan las secciones, las tablas mantienen sus filas y columnas, y los enlaces conservan su destino, así que un agente puede seguirlos.
Qué Recibes
El cuerpo de la respuesta es Markdown, con Content-Type: text/markdown. Conserva:
- encabezados, párrafos y listas
- tablas, como tablas Markdown
- enlaces, con URLs absolutas
- imágenes, como
 - bloques de código
Elimina scripts, estilos, diálogos de cookies, botones y formularios, y elementos ocultos. Por defecto también deja fuera la navegación y el pie de página; más sobre esto abajo.
Esta es la respuesta para una página de producto de books.toscrape.com, una tienda de demostración creada para practicar scraping (con la descripción acortada):
- [Home](https://books.toscrape.com/index.html)
- [Books](https://books.toscrape.com/catalogue/category/books_1/index.html)
- [Poetry](https://books.toscrape.com/catalogue/category/books/poetry_23/index.html)
- A Light in the Attic
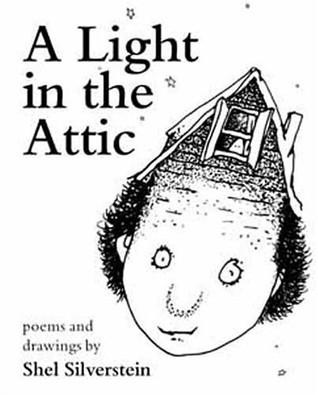
# A Light in the Attic
£51.77
In stock (22 available)
## Product Description
It's hard to imagine a world without A Light in the Attic. ...
## Product Information
| UPC | a897fe39b1053632 |
| --- | --- |
| Product Type | Books |
| Price (excl. tax) | £51.77 |
| Price (incl. tax) | £51.77 |
| Tax | £0.00 |
| Availability | In stock (22 available) |
| Number of reviews | 0 |La ruta de navegación, la imagen de portada con su texto alternativo, el precio y la tabla de detalles del producto llegan completos, y los enlaces apuntan a URLs completas.
Cómo Pedir Markdown
cURL
Añade markdown=true a una petición normal a /getPageSource:
curl -X POST "https://api.scrapeunblocker.com/getPageSource?url=https://en.wikipedia.org/wiki/Web_scraping&markdown=true" \
  -H "x-scrapeunblocker-key: YOUR_API_KEY"
Python
Solo con requests:
import requests

r = requests.post(
    "https://api.scrapeunblocker.com/getPageSource",
    params={"url": "https://en.wikipedia.org/wiki/Web_scraping", "markdown": True},
    headers={"x-scrapeunblocker-key": "YOUR_API_KEY"},
    timeout=120,
)
r.raise_for_status()
markdown = r.text
O con el SDK oficial (pip install scrapeunblocker, versión 0.13.0 o posterior), que lee tu clave de la variable de entorno SCRAPEUNBLOCKER_KEY:
from scrapeunblocker import Client

su = Client()  # lee SCRAPEUNBLOCKER_KEY
markdown = su.get_markdown("https://en.wikipedia.org/wiki/Web_scraping")
Node.js
import { ScrapeUnblockerClient } from "scrapeunblocker";

const su = new ScrapeUnblockerClient(); // lee SCRAPEUNBLOCKER_KEY
const markdown = await su.getMarkdown("https://en.wikipedia.org/wiki/Web_scraping");
El SDK de Ruby tiene la misma llamada como get_markdown, y el de PHP como getMarkdown.
Solo el Contenido Principal o la Página Entera
Por defecto recibes solo el contenido principal de la página. La navegación, la cabecera del sitio, el pie de página y las barras laterales se quedan fuera, porque se repiten en cada página del sitio y rara vez responden a la pregunta que haces. Ese valor por defecto es main_content_only=true.
A veces lo que necesitas está fuera del contenido principal: los datos de contacto del pie, o los enlaces de navegación cuando un agente debe explorar el resto del sitio. Usa main_content_only=false para convertir la página entera:
curl -X POST "https://api.scrapeunblocker.com/getPageSource?url=https://example.com&markdown=true&main_content_only=false" \
  -H "x-scrapeunblocker-key: YOUR_API_KEY"
En el SDK de Python es su.get_markdown(url, main_content_only=False).
Funciona en Sitios Protegidos
Convertir HTML en Markdown es la parte fácil. Muchas librerías de código abierto lo hacen y puedes ejecutar una tú mismo. Lo difícil es conseguir la página real. Si le pasas a un conversor un desafío de Cloudflare o el esqueleto vacío de una página JavaScript, obtienes una copia en Markdown, muy ordenada, de la página del desafío.
Una petición de Markdown pasa por el mismo proceso que una de HTML:
- Renderizado de JavaScript en un navegador real, para que las páginas que construyen su contenido en el cliente lleguen completas.
- Evasión antibot para Cloudflare, DataDome, PerimeterX y Akamai.
- Segmentación por país con
proxy_country, para páginas que cambian según la ubicación. - Pasos de navegador con
steps: haz clic en “cargar más”, escribe en un buscador o espera a un elemento, y la página se convierte después de ejecutar los pasos. - Páginas en vivo. Cada llamada obtiene la página tal como está ahora; nada sale de una caché.
El precio tampoco cambia. Una llamada en Markdown se factura exactamente igual que una llamada HTML, y solo cuando se entrega la página. Los bloqueos, los tiempos de espera agotados y los errores de nuestro lado no cuestan nada.
¿Markdown, Datos Parseados o HTML?
Los tres salen del mismo endpoint, así que elige según lo que vaya a pasar después con la página:
| Quieres | Usa |
|---|---|
| Darle una página a un LLM: resúmenes, preguntas y respuestas, RAG, agentes | markdown=true |
| Guardar campos en una base de datos: precio, título, disponibilidad, especificaciones | parsed_data=true |
| Ejecutar tus propios selectores o parsers | el HTML por defecto |
Markdown es para leer. Si necesitas un precio como número en una columna, parsed_data=true devuelve JSON estructurado, y nuestra guía sobre datos Schema.org y JSON-LD explica de dónde suelen salir esos campos. Cada una de estas opciones devuelve su propio formato, así que markdown=true no se puede combinar con parsed_data, get_cookies ni list_elements. Una petición así se rechaza con un 422.
Ejemplo: Dividir una Página para un Índice RAG
Los encabezados de Markdown te dan puntos naturales para dividir una página. Este esbozo obtiene un artículo y agrupa sus secciones en fragmentos de hasta unos 4.000 caracteres, listos para tu modelo de embeddings:
import re
from scrapeunblocker import Client

su = Client()

def chunk_markdown(md, max_chars=4000):
    chunks, current = [], ""
    for section in re.split(r"\n(?=#{1,3} )", md):
        if current.strip() and len(current) + len(section) > max_chars:
            chunks.append(current.strip())
            current = ""
        current += section + "\n"
    if current.strip():
        chunks.append(current.strip())
    return chunks

md = su.get_markdown("https://en.wikipedia.org/wiki/Web_scraping")
for chunk in chunk_markdown(md):
    print(len(chunk), chunk.splitlines()[0][:70])
Los fragmentos solo se cortan en los encabezados, así que cada uno contiene secciones enteras y empieza con su propio encabezado como contexto. Una sección más larga que el límite se queda en una sola pieza. Dos mejoras para producción: divide las secciones muy largas por párrafos e ignora las líneas con # dentro de bloques de código, que son comentarios y no encabezados.
Para Asistentes de IA: el Servidor MCP
Si tu agente funciona en Claude, ChatGPT, Cursor u otro cliente MCP, no tienes que escribir la petición tú mismo. El servidor MCP de ScrapeUnblocker tiene una herramienta fetch_markdown que lee una página como Markdown, y search_and_read, que hace una búsqueda en Google y devuelve los primeros resultados como Markdown en una sola llamada.
Preguntas Frecuentes
¿Markdown cuesta más que HTML?
No. Una llamada en Markdown se factura exactamente igual que una llamada HTML, y solo cuando se entrega la página.
¿Puedo obtener también la navegación y el pie de página?
Sí. Añade main_content_only=false y se convierte la página entera. Sin ese parámetro recibes solo el contenido principal.
¿Funciona con páginas protegidas o muy dependientes de JavaScript?
Sí. La página se renderiza en un navegador real y se obtiene con la misma evasión antibot que una llamada HTML, y proxy_country y steps funcionan igual.
¿Puedo combinar markdown=true con parsed_data=true?
No. Cada uno devuelve su propio formato, así que la API responde a esa combinación con un 422. Si necesitas ambos, haz dos llamadas.
Pruébalo con Tus Propias Páginas
Cada cuenta nueva recibe 500 solicitudes gratis, sin tarjeta, y una llamada en Markdown cuesta una solicitud, como cualquier otra página. Regístrate en app.scrapeunblocker.com, añade markdown=true a tu próxima petición y consulta la guía de Markdown en la documentación para ver todas las opciones.
Prueba ScrapeUnblocker gratis
Tasa de éxito del 95%+ · desde 0,55 € por cada 1000 llamadas (puede aplicarse IVA) · 500 solicitudes gratis al registrarte.